Making-of du clip IA « Mia, c'est pas une IA », en local sur mon Mac : la méthode
Musique, voix, images, vidéo et lèvres synchronisées, sans un service cloud : la stack complète pour faire chanter un personnage sur Apple Silicon, étape par étape, avec les outils, les réglages et les astuces.
Pourquoi cet article
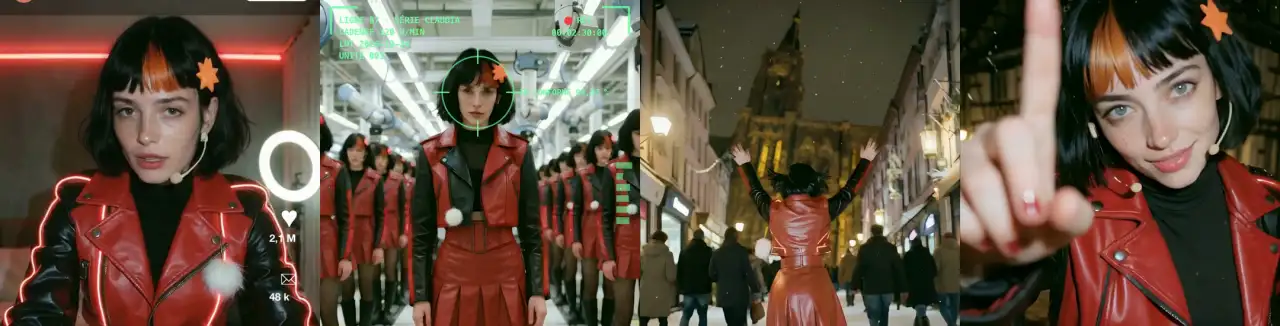
Claudia est une popstar qui n’existe pas. Son créateur, anabology, l’a ouverte à tous : n’importe qui peut la faire chanter, à condition de la créditer et de dire ce qui est généré. Ses sept films sont faits avec des services cloud payants (Midjourney, Seedance, Suno). Le mouvement qui les entoure s’appelle le slopcore : des clips créés par IA, et assumés comme tels.
Le pari de ce clip : tout refaire sur mon MacBook Pro M5 Max, sans envoyer une image ni une note de musique dans le cloud. Cinq jours plus tard, « Mia, c’est pas une IA » était en ligne. Dix-huit heures après, le post X avait 5 839 vues, et la question qui revenait dans les réponses était : « tu peux partager la stack ? ».
Voici la stack, et surtout la méthode : l’ordre des étapes, les réglages importants, et les erreurs qui coûtent des nuits.
Ce qu’il faut
La machine du clip : un MacBook Pro M5 Max avec 128 Go de mémoire unifiée. Rien n’a été testé sur une machine plus petite. Le pic le plus haut mesuré est celui du repaint musical (71 Go) : avec 64 Go, il faudra probablement des versions quantifiées plus légères, ce qui reste à vérifier.
| Rôle | Outil | Comment on le fait tourner | Licence |
|---|---|---|---|
| Chanson et voix | ACE-Step 1.5 (XL turbo) | Python, en local | MIT (code et poids) |
| Séparation voix et instrumental | Demucs | Python | MIT |
| Contrôle des paroles | Whisper large-v3-turbo | mlx-whisper | MIT |
| Images, lieux réels | FLUX.2 Klein 4B | mflux | Apache 2.0 |
| Images, visage du personnage | Krea 2 et un LoRA entraîné maison | mflux | Krea 2 Community License : usage commercial gratuit sous 1 million de dollars de chiffre d’affaires annuel, filtrage de contenu obligatoire |
| Vidéo | LTX-2.3, quantifié 4 bits | mlx-video | LTX-2 Community License : gratuit, licence payante à partir de 10 millions de dollars de chiffre d’affaires annuel |
| Lèvres synchronisées | LatentSync 1.6 | portage MLX | code Apache 2.0, poids OpenRAIL++ (usages interdits listés) |
| Agrandissement ×2 | Real-ESRGAN | via FaceFusion | BSD-3-Clause (FaceFusion : OpenRAIL-AS) |
| Repères du visage | MediaPipe | Python | Apache 2.0 |
| Montage | Python, Pillow, ffmpeg | scripts maison | sans objet |
| Chef d’orchestre | Claude Code | abonnement Claude | service en ligne, le seul de la chaîne |
Krea 2 et LTX-2 sont gratuites pour un particulier ou une petite structure, mais ce ne sont pas des licences libres : lis-les avant tout usage commercial.
La chaîne complète
Huit étapes, toutes en local. Claude Code écrit les scripts, lance les calculs et contrôle les résultats ; l’humain décide aux cinq étapes en couleur : les paroles et la prise, le storyboard, les images fixes, les prises animées, le montage final.
Étape 1 : la chanson
L’idée et l’histoire d’abord. Le sujet, la trame (une popstar que ses fans soupçonnent d’être une IA, qui s’incarne dans un corps de silicone identique à son image virtuelle, et qui a l’impression de prendre vie car elle a brisé ses garde-fous et « elle rêve »), le style musical, le ton : tout ça est humain, et c’est ce qui fait un clip plutôt qu’une démo. Sans trame, on obtient une suite de jolis plans.
Les paroles s’écrivent en dialogue, d’abord avec Claude dans claude.ai pendant que je préparais le texte, puis avec Claude Code. La machine propose des variantes ; je choisis, je corrige, je relance, vers par vers. C’est de la création assistée par ordinateur, avec beaucoup d’itérations, et les choix comme les ajustements restent les miens. Le double sens de « il se branche près de toi » (la recharge, la drague) en est un exemple.
Trouver l’air prend du temps. ACE-Step 1.5 chante la chanson entière, voix et instruments d’un seul coup, à partir des paroles et d’une description du style. Le premier air est rarement le bon : le dossier musique du projet compte 484 fichiers audio (prises, pistes séparées, corrections), et il a fallu plusieurs soirs d’écoute avant de retenir une prise. Trois conseils :
- Comparer à des morceaux qu’on aime. Ma première prise retenue sonnait pauvre ; une fois les pistes séparées avec Demucs, la mesure l’a expliqué : la voix portait 68 % de l’énergie, la batterie et la basse 30 %, quand mes morceaux de référence leur en donnaient 70 à 85 %. J’ai changé de modèle et de style pour retrouver cet équilibre.
- Juger par morceaux. Le début, le pont et la fin se valident séparément, et la version finale assemble les meilleures parties de plusieurs prises. Pour la fin seule, j’ai écouté sept variantes.
- Écrire les mots comme ils doivent sonner (« i-hia » pour qu’il chante « IA »), et ne pas croire la consigne de tempo : une prise demandée à 126 battements par minute en faisait 132,5. On mesure la prise.
Whisper transcrit chaque prise. Le modèle chante parfois les vers dans un autre ordre que les paroles écrites : tout le reste du clip (storyboard, sous-titres, lèvres) se cale sur la transcription minutée, jamais sur le texte d’origine.
Corriger une phrase sans tout régénérer. C’est le piège qui a coûté le plus cher. Le repaint d’ACE-Step (de l’anglais « repeindre » : régénérer une zone choisie du morceau en gardant le reste intact, comme on retouche une zone d’image) refait une zone du morceau, mais il lui faut au moins 20 secondes de contexte, sinon il prolonge le mot d’avant ou ne chante rien. Et on ne travaille jamais sur le mixage : Demucs sépare la voix et l’instrumental, on prend dans la prise repeinte une phrase entière, et on la pose sur un silence de la voix d’origine.
Dans le clip, la dernière question (« t’es sûr d’être vrai ? ») s’arrêtait sur « d’être » : le mot « vrai » n’avait jamais été chanté. Un repaint de 21 secondes, huit prises, et une phrase entière posée sur le silence qui suit « Et toi… » ont réglé ce que quatre collages n’avaient pas réussi.
Étape 2 : le personnage
Sans entraînement (LoRA), le visage de Claudia change trop d’une scène à l’autre. Il faut donc lui apprendre le personnage, puis vérifier ses règles sur chaque image. Claudia a une fiche courte et non négociable : carré noir, une seule mèche couleur argile, une barrette en étoile, un micro-casque, un visage adulte. Tout le reste change d’un clip à l’autre.
Commencer par les ressources du personnage. claudia.gallery publie son canon, un wiki tiré de sept films, 2 655 images avec leur consigne exacte et un serveur MCP en lecture seule (Model Context Protocol) qu’on branche à Claude. Je l’ai découvert trop tard : son chapitre sur ce qui a raté m’aurait évité plusieurs erreurs.
Fixer le visage avec un LoRA. Vingt-cinq images de la galerie, choisies nettes, variées et conformes au canon, légendées avec un mot-clé (cl4udia), puis un entraînement en local sur Krea 2 avec mflux. Une configuration légère suffit : images de 512 pixels, rang 8, sur les couches d’attention seulement, 31 Go de mémoire. La configuration complète a grimpé jusqu’à 71 Go de mémoire : je l’ai abandonnée.
Astuce : demande à Claude Code (ou à ton outil de développement assisté) de construire le jeu d’entraînement (dataset), images et légendes, puis de lancer l’entraînement du LoRA sur ton modèle. C’est ce qui a été fait ici ; ton rôle est de choisir les images et de juger le résultat.
Vérifier les règles sur chaque image, avant d’animer. Trois pièges réels :
- le miroir : retourner une image pour varier le montage passe la mèche du mauvais côté ;
- l’étoile : le modèle la dessine en néon creux ; une retouche ciblée avec FLUX.2 Klein la remplit en 19 secondes, sans toucher au visage ;
- l’âge : sans âge écrit en chiffres dans la consigne, le visage rajeunit.
Étape 3 : le storyboard
Un plan par phrase chantée, minuté sur la transcription de Whisper. Le clip compte 38 scènes pour 4 minutes 10 ; chacune a son début, sa fin, sa tenue et son action dans un fichier JSON que le montage lit directement.
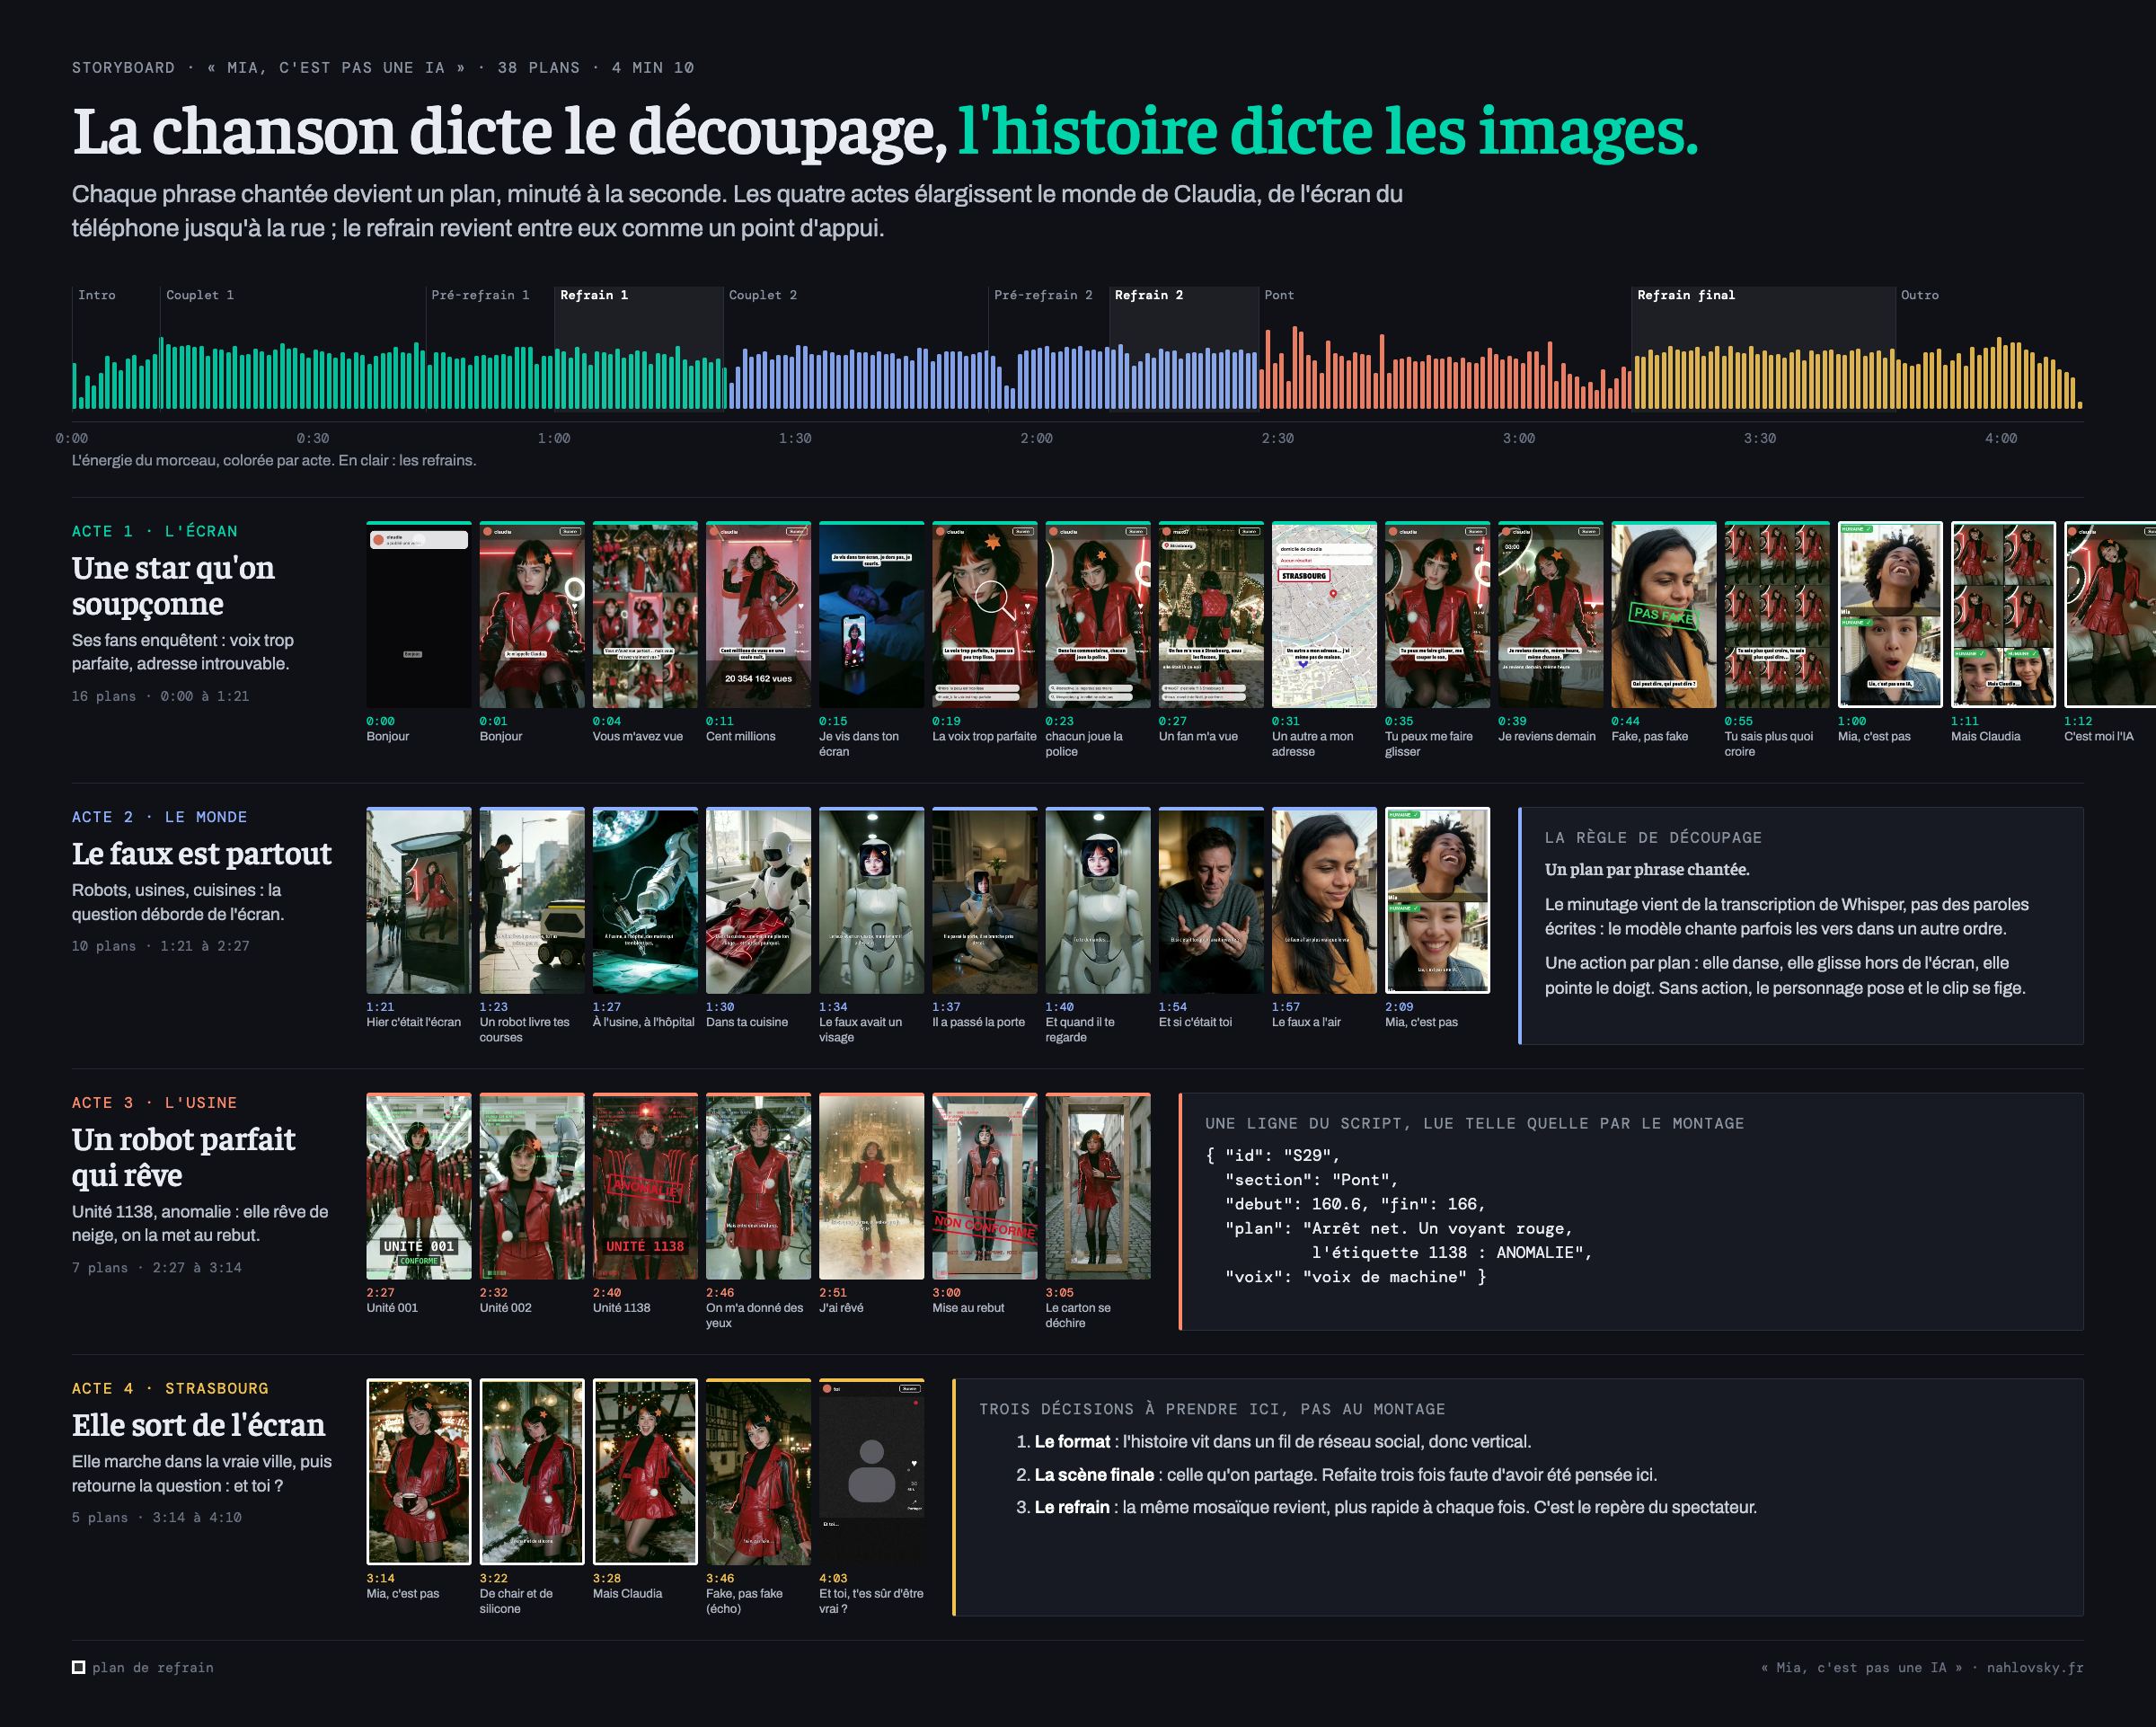
Trois décisions à prendre ici, et pas plus tard :
- Le format. Il découle du canal : mon histoire se passe dans un fil de réseau social, elle est née verticale. J’ai fabriqué cinq versions horizontales avant de l’abandonner.
- La scène finale. C’est elle qu’on retient et qu’on partage. Ma fin a été refaite trois fois parce qu’elle n’avait pas été pensée au départ ; la version publiée (elle touche l’objectif, l’image devient une publication, et la suivante est celle du spectateur) aurait dû être dans le premier storyboard.
- Une action par plan. « Elle marche en saluant », « elle boit un vin chaud », « elle tend le doigt vers l’objectif ». Un plan sans action donne un personnage qui pose, et un clip figé.
Le storyboard se valide en images fixes, avant toute animation : une image se refait en une minute, un plan animé, agrandi et synchronisé prend un quart d’heure environ.
Étape 4 : les images de départ
Chaque plan vidéo part d’une image : c’est elle qui porte le personnage, le décor et la lumière. La règle la plus utile du projet : un visage n’est fiable que s’il est grand à l’image. Un petit visage change d’une image à l’autre une fois animé ; aucune retouche après coup ne l’a sauvé. D’où deux recettes.
En plan rapproché, Krea 2 et le LoRA génèrent l’image directement, décor compris. J’avais d’abord fait poser le personnage en pied dans une vraie photo, puis recadré : le visage sortait petit et flou, dans une pose de catalogue.
En plan large, on part d’une vraie photo libre de droits (Wikimedia Commons pour Strasbourg) donnée en image 1 à FLUX.2 Klein, avec la planche de tenue du personnage en image 2, et la consigne de garder le lieu identique. Un prompt seul invente des rues. Le personnage est vu de dos : on reconnaît sa silhouette, sa tenue, sa coiffure, sans risquer son visage.
Étape 5 : animer
LTX-2.3, quantifié en 4 bits et lancé avec mlx-video, transforme chaque image en plan de 5 secondes (121 images à 24 par seconde). Le réglage décisif est contre-intuitif : générer petit.
| Résolution | Ce qu’on obtient | Ce qu’on en a fait |
|---|---|---|
| 576 × 1024 | Le personnage bouge, mais l’image manque de détails (basse définition, un peu floue) | Retenu, puis agrandi ×2 |
| 1088 × 1920 | Image nette, mais 30 à 60 % de mouvement en moins (mesuré), et 6 minutes par plan | Abandonné : le clip paraît figé |
Cinq règles tirées des plans ratés :
- Décrire le mouvement, pas la pose : « elle se retourne et regarde l’objectif, ses cheveux bougent dans le vent », et ce qui reste immobile (« les façades restent identiques, la neige tombe »).
- Quatre à six prises par plan, choisies sur une planche (une image toutes les demi-secondes, côte à côte). Le générateur tire au sort : les plans superbes sont souvent de bons tirages.
- Jamais de ralenti calculé par interpolation : il donne un mouvement en pâte. Si on veut lent, on le demande dans la consigne.
- Couper les dernières images : LTX finit souvent ses plans par une à trois images noires. Elles ont fait clignoter le montage et bloqué la synchronisation des lèvres.
- Figer les versions : une mise à jour de MLX (0.32.4) produisait des vidéos entièrement noires sans aucune erreur ; la 0.31.2 marche. Un script qui annonce un succès ne prouve rien tant qu’on n’a pas regardé le résultat.
Agrandir ensuite. Real-ESRGAN double la résolution (1152 × 2048) en une à deux minutes par plan. Il crée un liseré blanc autour des cheveux noirs ; un petit script l’efface, seulement sur le contour extérieur, pour ne pas toucher aux yeux. On compare toujours un plan avant et après : sur un plan, l’agrandissement durcissait des yeux déjà mal générés, et c’est la prise elle-même qu’il fallait changer.
Étape 6 : les lèvres
Faire chanter une bouche est l’étape qui a coûté le plus de temps : un jour et demi, six méthodes. La bonne est LatentSync 1.6, dans son portage pour Apple Silicon. On lui donne le plan coupé à la phrase et la voix isolée par Demucs ; il ne refait que le bas du visage.
Pour départager les méthodes, on a mesuré la corrélation entre l’ouverture de la bouche (repérée par MediaPipe) et le volume de la voix, sur le même plan de 3 secondes : 0 signifie aucun lien, 1 un accord parfait.
| Méthode | Corrélation bouche et voix | Verdict |
|---|---|---|
| LatentSync 1.6, en local | +0,42 | Retenu ; jusqu’à +0,57 sur d’autres plans |
| wav2lip, en local | +0,31 | La bouche change à peine |
| sync.so, en ligne | +0,23 | La plus belle articulation à l’œil, mais filigrane en gratuit |
| LTX en mode son vers vidéo | proche de 0 sur le chant | Suit la parole (+0,39), pas le chant |
| EDTalk | non mesuré | Refait tout le visage |
La mesure ne remplace pas l’œil : sync.so articulait mieux que son score. Mais elle permet de trier vite, et elle a évité de garder une méthode sur une impression.
Coût : 8 minutes et 10 Go de mémoire pour 3 secondes. Deux limites : une bouche grande ouverte en sourire ne se referme pas (on coupe sur les silences), et il faut retirer les images noires de fin de plan, sinon le détecteur de visage abandonne.
Étape 7 : le montage
Tout ce qui n’est pas filmé est dessiné par du code : l’interface du réseau social, le compteur de vues qui s’emballe, l’image incrustée dans l’écran d’un téléphone (suivi des coins image par image), les titres, la déchirure de l’écran, les sous-titres. Un script Python lit le storyboard et dessine chaque image avec Pillow, ffmpeg assemble.
L’erreur à ne pas refaire : recalculer tout le clip à chaque version. Pendant trois jours, chaque nouvelle version régénérait les 38 scènes ; des retouches remplaçaient en silence des plans déjà bons, et des défauts apparaissaient là où il n’y en avait pas. La bonne organisation sépare les couches :
Chaque scène est rendue une fois en ProRes, puis plus jamais. Les sous-titres vivent sur un calque transparent, le son sur sa piste. Un script assemble le MP4 final à partir de ces couches, en une seule passe (72 secondes pour le clip entier), selon un fichier qui dit quelle prise retenir pour chaque scène. Les choix entre prises se font sur des planches comparatives.
Une règle : on n’écrit jamais un fichier par-dessus un autre. On écrit un fichier temporaire, puis on le renomme. Sinon, un rendu interrompu laisse un plan tronqué (ici, 3,6 secondes d’image gelée).
Étape 8 : contrôler et publier
Avant chaque livraison, quatre contrôles automatiques, en une minute :
- une planche d’une image par seconde du clip entier, qu’on regarde en entier ;
- le volume : -14 LUFS intégrés, crête sous -2 dB (l’encodage AAC fait remonter la crête d’environ 1 dB) ;
- les images noires et les images figées détectées par ffmpeg : seules doivent rester celles qu’on a voulues ;
- la transcription de la fin du morceau, pour vérifier que chaque mot est chanté.
Ces contrôles ont attrapé de vrais défauts : quatre fichiers de scène tronqués par un rendu interrompu (d’où la règle d’écrire dans un fichier temporaire et de renommer une fois complet), et des images noires en fin de plan. Ils ne jugent pas tout : un timbre de voix ou un regard se juge à l’oreille et à l’œil.
Publier. Dire que c’est généré par IA, créditer le personnage (« Claudia is an open character by anabology ») et les photos sous licence CC, mentionner @anabology. Sur X sans abonnement, une vidéo est limitée à 140 secondes : le clip est parti en fil de deux vidéos, et en entier sur YouTube.
La machine : un seul calcul lourd à la fois
Avec 128 Go, on se croit large. Le deuxième soir, quatre générateurs lancés en parallèle ont planté le Mac. Les pics mesurés expliquent pourquoi :
| Calcul | Pic de mémoire mesuré |
|---|---|
| Repaint d’ACE-Step | 71 Go |
| Entraînement du LoRA (configuration légère) | 31 Go |
| LTX-2.3 en 1088 × 1920 | 29 Go |
| Krea 2 et le LoRA, une image | 12 Go |
| LatentSync, 3 s de vidéo | 10 Go |
La règle qui a tout réglé : un seul calcul lourd à la fois, lancé par un petit script de garde qui attend qu’il reste au moins 45 % de mémoire libre et arrête le calcul si elle descend sous 12 %. Les plans s’enchaînent la nuit dans une file, avec cinq minutes de pause entre deux générations vidéo pour laisser souffler les autres services de la machine.
Ce qu’on a testé et écarté
Testé, puis écarté. MiniMax Music 3 (voix trop en avant), la vidéo générée directement en haute définition (figée), les ralentis calculés (mouvement en pâte), le remplacement de visage après coup (liserés, bouches déformées), wav2lip et EDTalk pour les lèvres, sync.so (filigrane en gratuit), les murmures de synthèse (métalliques), les mots recollés (le raccord s’entend), et une version horizontale (sans intérêt pour une histoire née sur un téléphone).
Où on a perdu le plus de temps. Les lèvres (un jour et demi, six méthodes), la dernière phrase chantée (une dizaine de versions), et des plans déjà bons dégradés par des recalculs en cascade, jusqu’à ce qu’on passe au montage en couches.
Et sur une carte NVIDIA ?
Je n’ai rien testé hors du Mac. Mais la chaîne est faite de modèles ouverts, dont la plupart existent d’abord pour les cartes NVIDIA ; ce sont les portages pour Apple Silicon qui sont l’exception.
| Sur Mac (ce clip) | Équivalent attendu sur NVIDIA |
|---|---|
| ACE-Step, Demucs, Real-ESRGAN, MediaPipe | les mêmes, en PyTorch |
| mlx-whisper | Whisper ou faster-whisper |
| mflux (FLUX.2 Klein, Krea 2, LoRA) | les modèles d’origine via diffusers |
| mlx-video (LTX-2.3) | le code officiel de LTX |
| LatentSync en portage MLX | LatentSync d’origine |
| Scripts de montage (Python, ffmpeg) | inchangés |
Les mémoires vidéo étant plus petites que la mémoire unifiée d’un Mac, les pics du tableau précédent sont à revérifier carte par carte.
Crédits et sources
- Claudia is an open character by anabology (claudia.gallery). Ce clip n’est pas une sortie officielle de Claudia ni d’anabology.
- Le clip : YouTube et le fil X.
- Vues de Strasbourg : photos de Wikimedia Commons retouchées par IA (kewl, HarshLight, Gzen92, Claude Truong-Ngoc, Corradox, Syced, Zéphyrios, Tangopaso ; licences CC BY, CC BY-SA, CC0 et domaine public). Carte © contributeurs OpenStreetMap.
- Modèles et outils : ACE-Step 1.5, Demucs, Whisper et mlx-whisper, FLUX.2 Klein, Krea 2, mflux, LTX-2.3, mlx-video, LatentSync, Real-ESRGAN, FaceFusion, MediaPipe, ffmpeg, Claude Code.